Una receptionist IA full duplex che prenota appuntamenti (e non inventa niente)
Ho costruito un banco prenotazioni vocale con MiniCPM-o 4.5 che ascolta e parla insieme, legge uno schermo come contesto e scrive sul database solo quando il cliente dice sì.
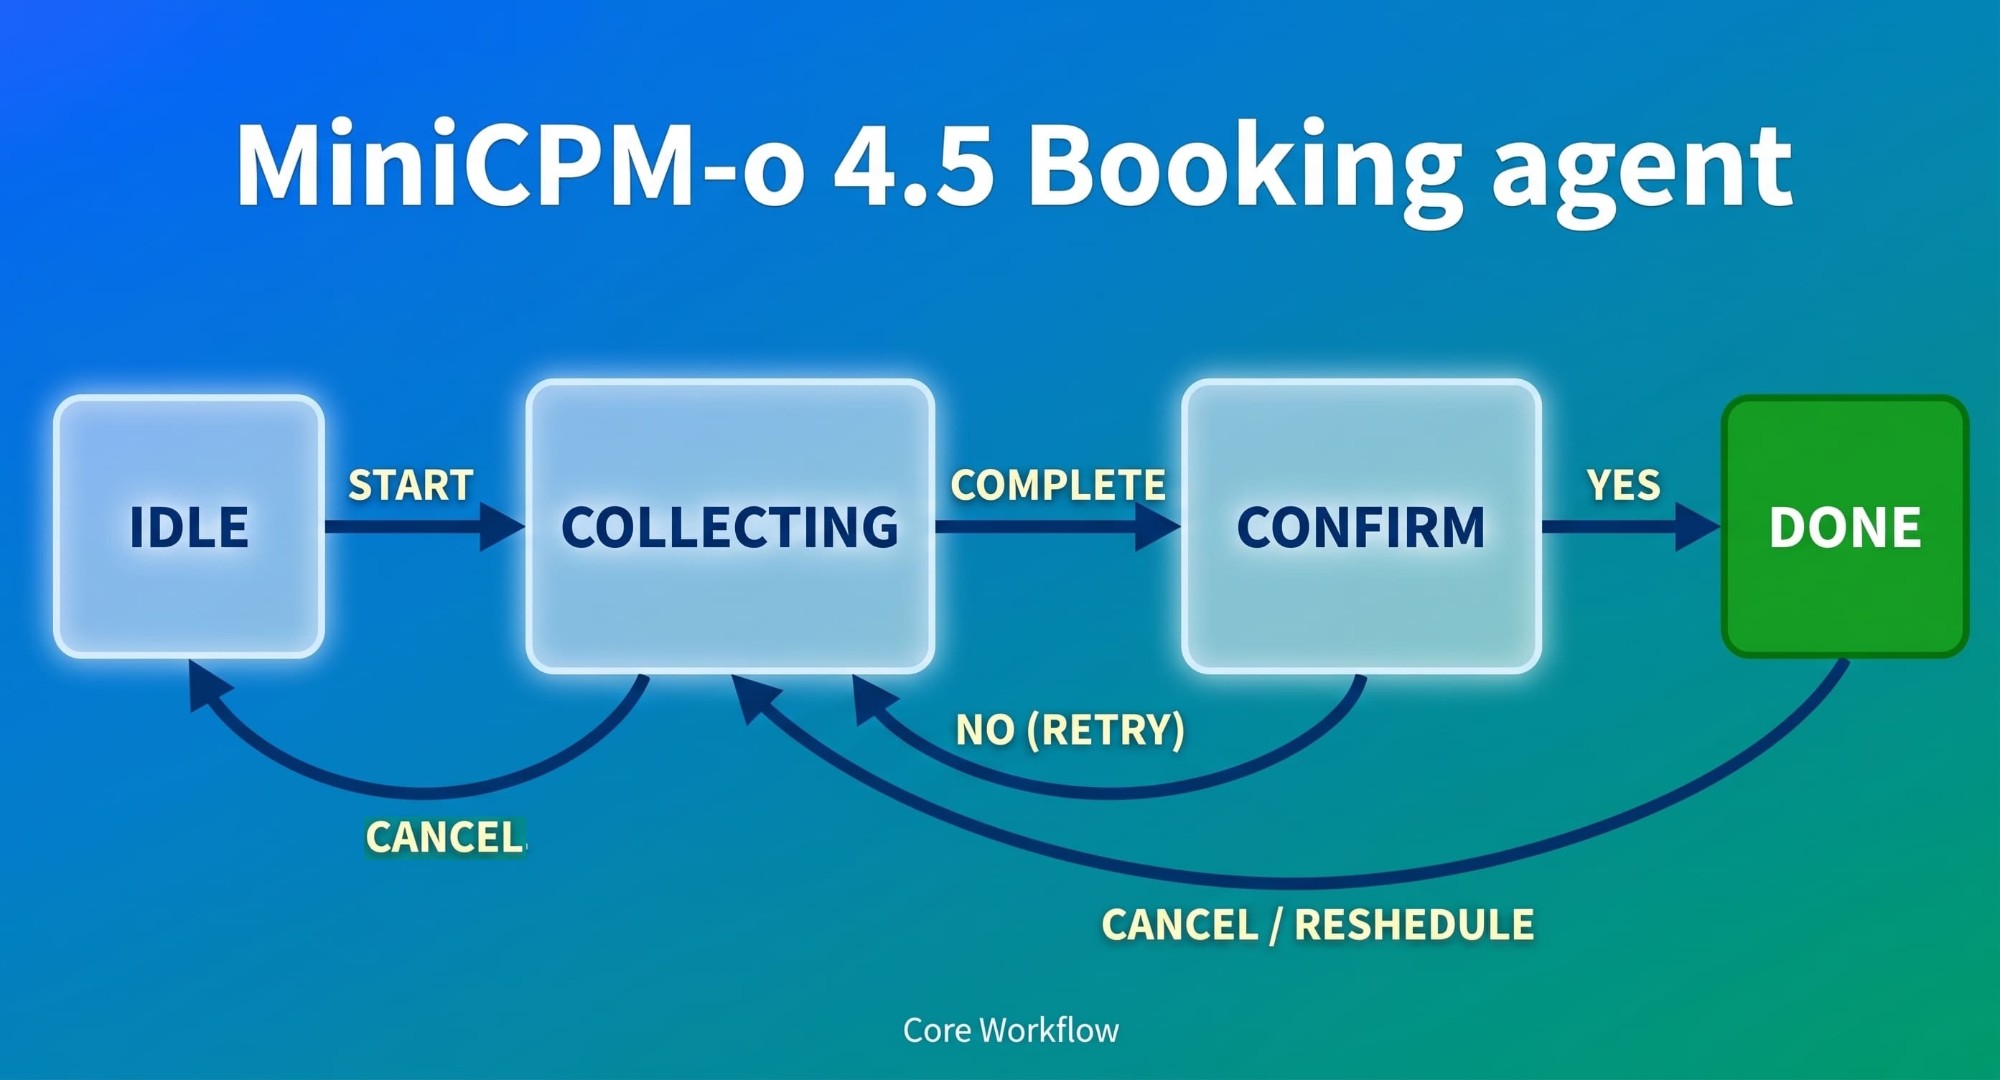
Un agente vocale full duplex che prende prenotazioni sul serio
Nella parte 6 di Emiglio avevo messo MiniCPM-o 4.5 dentro un robot per chiacchierare. Chiacchierare è divertente, ma un modello che parla in tempo reale diventa davvero interessante quando gli dai un lavoro: rispondere al telefono di uno studio, prendere un appuntamento, cancellarlo, e soprattutto non sbagliare.
Il progetto si chiama MiniCPM-o Booking Desk ed è una receptionist vocale che gestisce un calendario di appuntamenti in full duplex: ascolta e parla nello stesso momento, puoi interromperla, e non scrive mai una prenotazione sul database finché non hai detto esplicitamente di sì.
github.com/AlessandroBonomo28/Minicpm-o-booking-desk
Qui sotto c’è una sessione registrata di tre minuti, senza tagli, con una prenotazione, una cancellazione e qualche interruzione vera:
Il problema: un modello vocale non è un database
Un modello full duplex come MiniCPM-o è bravissimo a sembrare una persona, ma ha due difetti fatali per un lavoro da receptionist. Il primo è che non ha memoria affidabile: dopo qualche minuto la KV cache va potata (ne ho parlato nella parte 6) e il modello si dimentica tranquillamente che ti aveva promesso il giovedì alle 10. Il secondo è che inventa: se gli chiedi “è libero martedì?” ti risponde di sì con la stessa sicurezza con cui risponderebbe di no, perché non ha nessun calendario davanti, sta solo generando parole plausibili.
Se lasci che sia il modello a decidere cosa scrivere sul database, prima o poi ti ritrovi con un appuntamento fantasma. E un cliente che si presenta in studio per un appuntamento che non esiste è il modo più veloce per far cestinare il progetto.
La soluzione che ho adottato è separare nettamente le due cose: il modello parla, il codice decide. Il modello non ha nessuno strumento per scrivere sul database. Tutte le scritture passano da una macchina a stati deterministica in Python che valida ogni dato e agisce solo su un consenso esplicito del cliente.
Come funziona
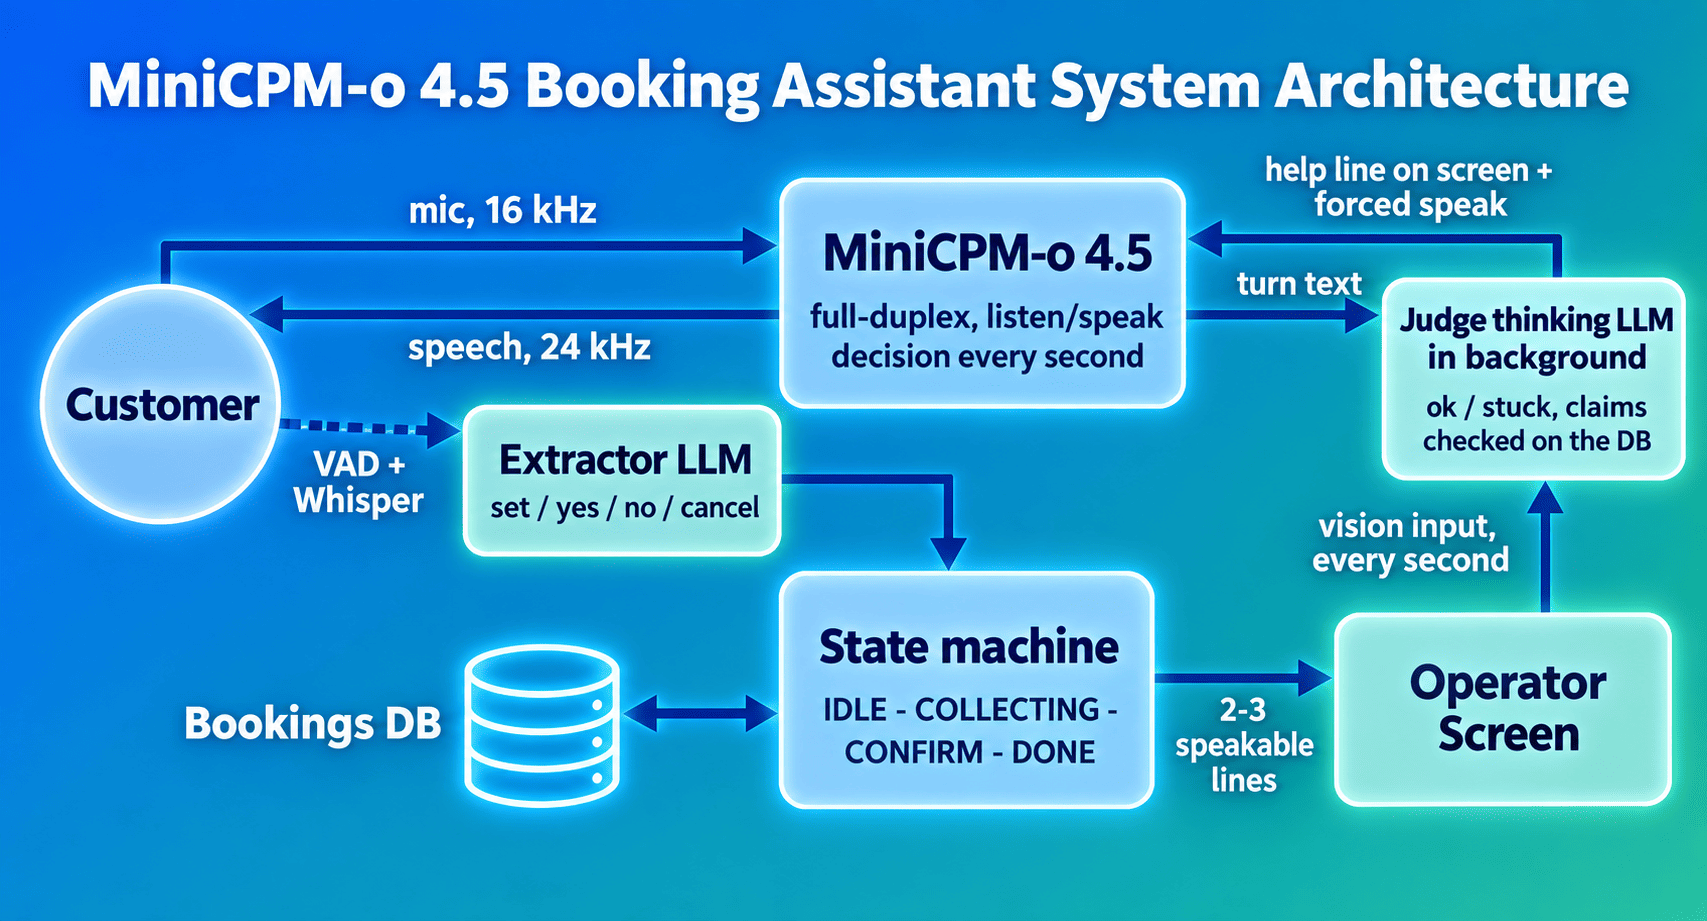 L’architettura completa: il cliente parla al modello, ma a scrivere sul database è solo la macchina a stati
Il sistema gira su tre canali paralleli che arrivano tutti al modello.
Il canale audio è il più ovvio: il microfono del cliente a 16 kHz entra, la voce del modello a 24 kHz esce. Non c’è nessuna voce sintetica iniettata nel mezzo: quando parlare lo decide il modello, con il suo meccanismo naturale di rilevamento della pausa.
Il canale visivo è il trucco che tiene in piedi tutto. MiniCPM-o vede, quindi invece di provare a fargli “ricordare” lo stato della prenotazione gli faccio guardare uno schermo. È lo schermo operatore: due o tre frasi rivolte al cliente, tipo “BOOK: APRIL 8? DOES THAT WORK?”, aggiornate ogni secondo dalla macchina a stati. Il modello le legge come se fosse un impiegato con un post-it davanti. Non è un’istruzione, è stato percepibile: non si può dimenticare perché è sempre lì, nell’ultimo fotogramma.
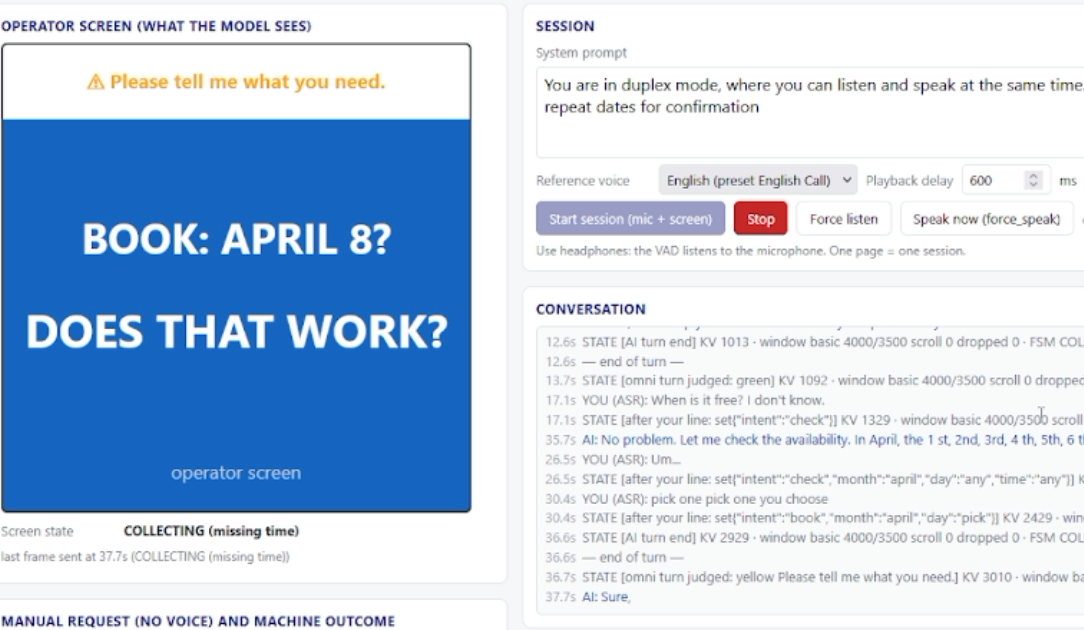 A sinistra lo schermo che vede il modello, a destra il log della sessione con lo stato della macchina e la dimensione della KV cache
Il canale di controllo sono due token, force_listen che esisteva già nel modello e force_speak che ho aggiunto io, con cui il codice può forzare il turno una volta al secondo. Servono quando la macchina a stati ha qualcosa di urgente da far dire, per esempio una correzione.
Per capire dove si infilano questi token bisogna guardare come lavora MiniCPM-o sotto il cofano:
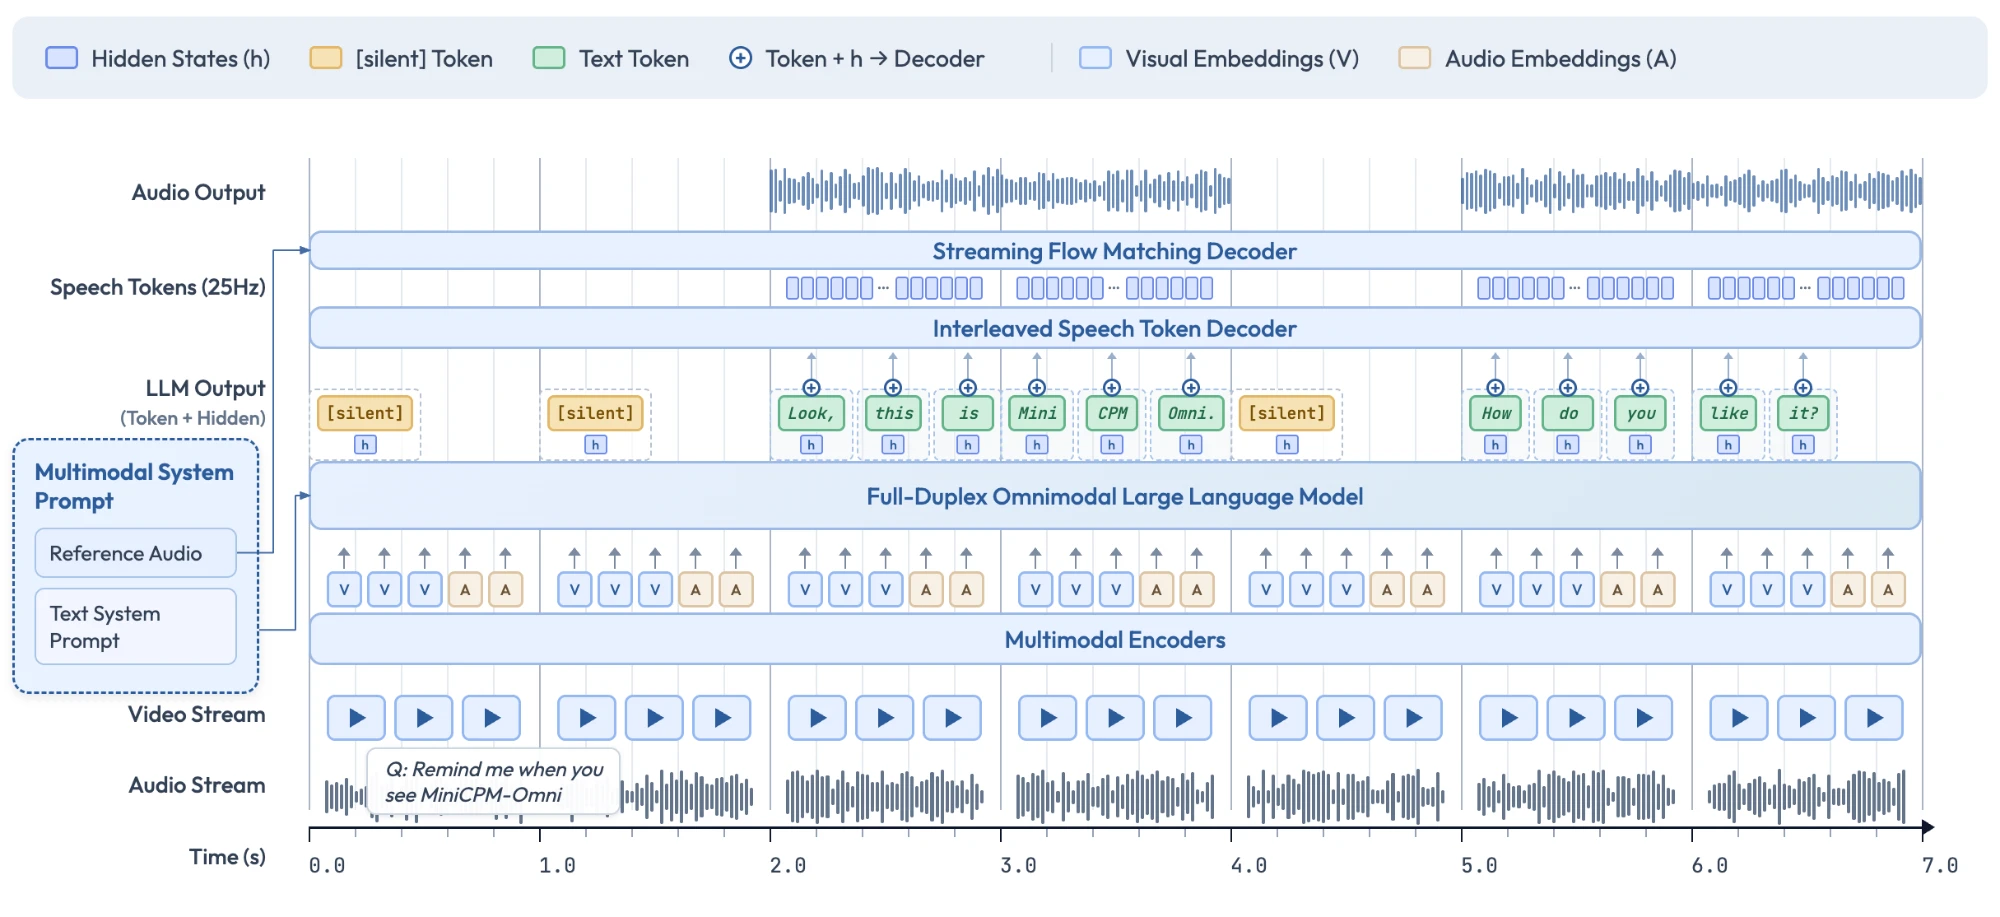 Come il modello gestisce il full duplex: video e audio entrano a blocchi di un secondo, e per ogni blocco il modello decide se stare zitto (
[silent]) o generare parole
Video e audio vengono spezzettati in blocchi da un secondo e infilati nel contesto come un’unica sequenza. Per ogni blocco il modello sceglie: o emette un token [silent], e quindi continua solo ad ascoltare, oppure emette testo, che un decoder trasforma subito in voce. È esattamente in questa scelta che si inseriscono force_speak e force_listen: il codice non mette parole in bocca al modello, gli dice solo adesso tocca a te o adesso stai zitto.
La catena per ogni frase del cliente
Quando il cliente finisce di parlare succedono, nell’ordine, queste cose:
- Un VAD nel browser sente 300 ms di silenzio e chiude la frase.
- Whisper (large-v3-turbo) la trascrive. Sì, c’è una trascrizione a lato, ma non è nel percorso della voce: serve solo al codice, il modello continua a sentire l’audio vero.
- Un piccolo LLM, l’extractor, legge la trascrizione e lo stato della sessione e sputa uno solo di quattro eventi:
set(il cliente ha detto un dato: mese, giorno, ora),yes,no,cancel. Niente di più. Non può inventare azioni. - La macchina a stati in
gateway.pyriceve l’evento, valida i dati, controlla il calendario, e aggiorna lo schermo operatore. È il diagramma in copertina: si parte daIDLE, si passa aCOLLECTINGmentre si raccolgono mese, giorno e ora, poi aCONFIRM, e solo unyesda lì porta aDONEe scrive sul database. Un “sì” detto in qualunque altro momento non scrive niente. - MiniCPM-o nel frattempo ha sentito il cliente e sta leggendo lo schermo nuovo, quindi risponde con la voce.
- Un secondo LLM, il judge, ascolta quello che il modello ha detto e lo confronta con lo stato reale del database. Se il modello ha affermato una cosa falsa (“perfetto, prenotato!” quando non lo è), è andato fuori contesto o sta ripetendo la stessa frase, il judge mette in coda un prompt di correzione, e al secondo successivo il modello si corregge da solo.
Il punto 6 è quello che mi piace di più. Il modello non è mai perfetto, quindi invece di cercare di renderlo perfetto ho messo qualcuno che lo controlla in tempo reale. Nelle sessioni di test il judge interviene tre o quattro volte a sessione, e ogni volta a ragione.
La memoria che non scade
Come nella parte 6, la KV cache del modello ha una finestra scorrevole (da 4000 a 3500 token), ma qui con una differenza: il system prompt viene sempre preservato in testa alla finestra, così il modello non perde mai il suo ruolo. E siccome tutto lo stato che conta è sullo schermo, e non nella memoria del modello, potare la cache non rompe niente.
I numeri
Nelle sessioni di riferimento, da 2 a 4 minuti con più operazioni ciascuna, ho avuto zero scritture sbagliate sul database. La latenza dell’extractor è tra 1 e 1,4 secondi, quella del judge sotto 1,2, e forzare l’apertura di un turno costa circa 0,6 secondi. Ci sono anche dei test di regressione nel repo: 40/40 sulla normalizzazione delle date, 76/76 sul replay della macchina a stati, 58/58 sull’extractor.
Il tutto gira su una sola GPU: una RTX 5090 con circa 29 GB di VRAM occupati tra MiniCPM-o e Whisper. Extractor e judge chiamano un modello cloud leggero (Gemini Flash Lite), ma c’è un fallback locale con Qwen3-1.7B se si vuole restare completamente offline, con qualche punto di accuratezza in meno.
I limiti
Sarei disonesto a non elencarli.
- Granularità di un secondo. Le decisioni di turno e le correzioni del judge arrivano al secondo successivo, quindi una frase sbagliata può partire prima di essere corretta.
- Solo inglese, per ora.
- Serve una cuffia. Non c’è cancellazione dell’eco tra la voce del modello e il microfono, stesso problema di Emiglio.
- Extractor e judge sono cloud di default.
- Su turni molto brevi, dopo un “uhm” di riempimento, ogni tanto il modello infila qualche fonema che non è inglese.
C’è anche una considerazione più generale: modelli più nuovi come DuplexOmni stanno portando il ragionamento in tempo reale direttamente dentro il percorso audio, e a quel punto una parte di questa orchestrazione potrebbe diventare superflua. Ma la struttura, con un modello che parla, uno schermo che è la fonte di verità e un codice che è l’unico a scrivere, dovrebbe trasferirsi pari pari su una base più forte.
Per provarlo
Serve una GPU da 32 GB, Python 3.10 con PyTorch CUDA, i pesi di MiniCPM-o 4.5 da Hugging Face e una chiave API per l’extractor. Poi:
1
bash tools/run_desk.sh
e si apre https://localhost:8006/static/hud/hud.html, dove c’è lo schermo operatore e la vista sul database delle prenotazioni. I dettagli, la configurazione e i benchmark sono tutti nel README.
Il progetto è costruito sopra la demo ufficiale di OpenBMB e sul modello MiniCPM-o 4.5, con Whisper di OpenAI per la trascrizione. La logica del banco, lo schermo operatore, il judge e le modifiche al modello sono mie.
STAY TUNED per i prossimi tutorial!