Emiglio vede, ascolta e parla in tempo reale (Parte 6)
Emiglio trasmette video e audio dal Raspberry Pi a MiniCPM-o 4.5 in full duplex, e la conversazione non si pianta più dopo pochi minuti.
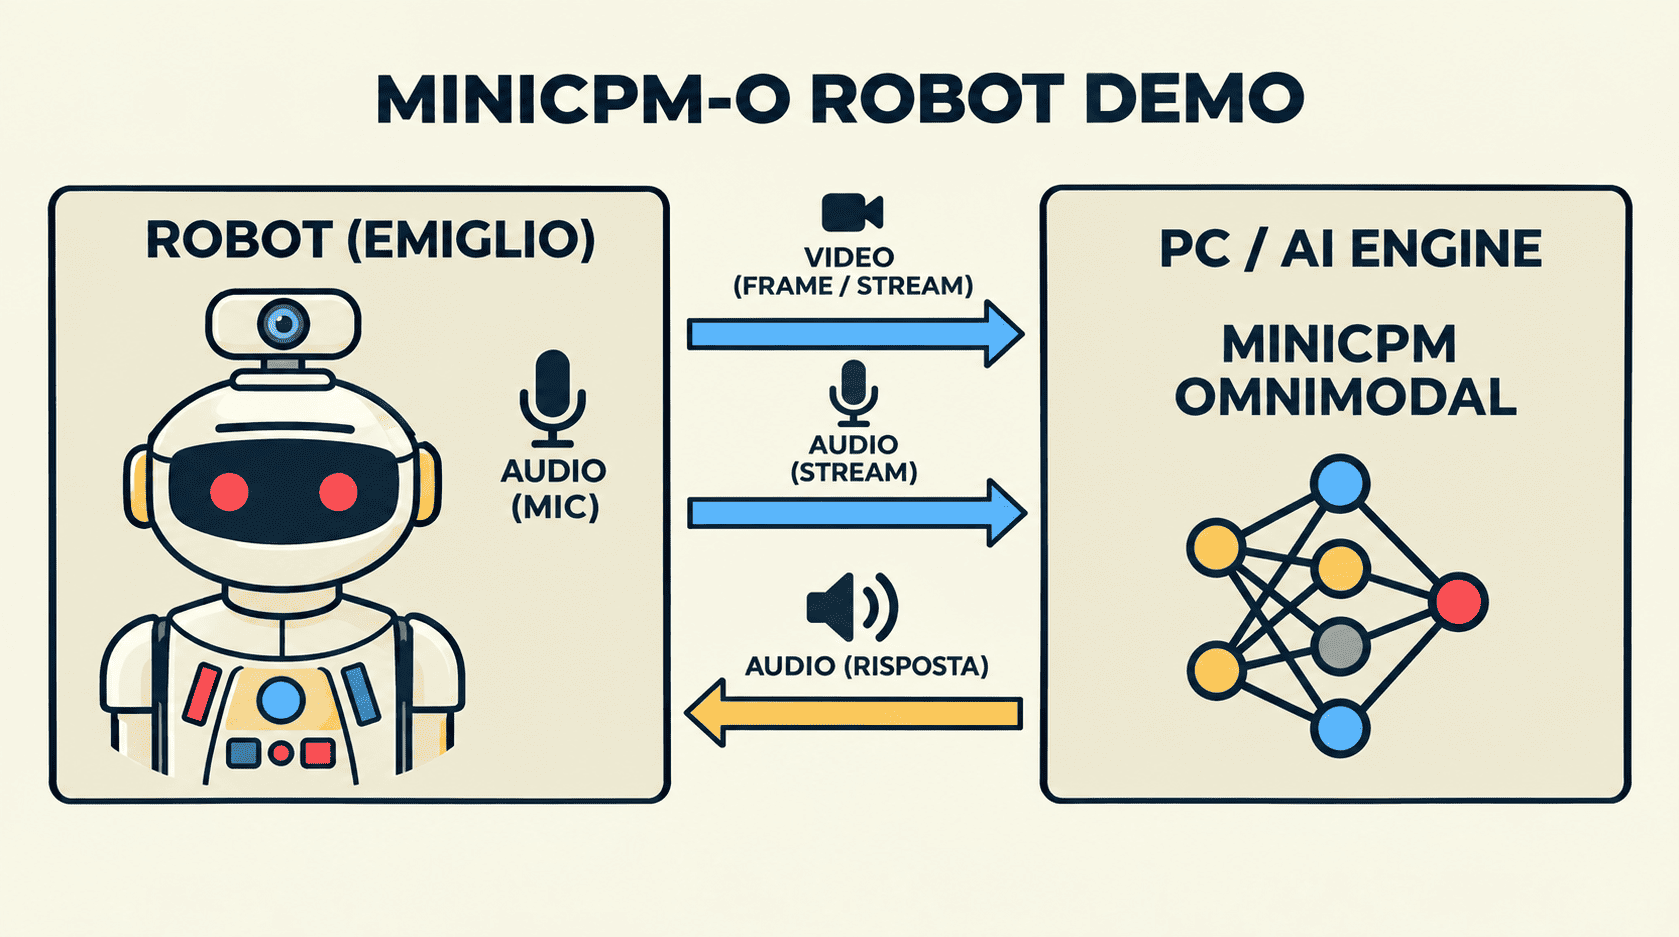
Un’IA full duplex per Emiglio: streaming dal Raspberry Pi a MiniCPM-o 4.5
Nelle prime cinque parti Emiglio ha imparato a muoversi col radiocomando RC, a ragionare in locale, a suonare in bluetooth, a camminare sui cingoli e ha ricevuto una scheda tutta sua.
Nella parte 4, tra i prossimi sviluppi, avevo scritto “IA full duplex che risponde in real time”. Eccola.
Finora Emiglio parlava a turni: io parlo, lui ascolta, poi risponde, e nel frattempo non vede niente. Con un modello full duplex invece l’IA vede, ascolta e parla nello stesso momento, come in una videochiamata: può interromperti, commentare quello che ha davanti e decidere da sola quando è il momento di aprire bocca.
Il progetto è diviso in due repo:
- emiglio-stream: la parte che gira su Emiglio. Il Raspberry Pi Zero 2 W prende il video dalla webcam e l’audio dal microfono del ReSpeaker, li manda al PC, e riproduce sull’altoparlante la voce che torna indietro.
- MiniCPM-o-Demo-kvpurge: il cervello. È un fork della demo ufficiale di MiniCPM-o 4.5, un modello omnimodale da 9 miliardi di parametri, che gira in locale su una RTX 5090. L’ho modificato perché la demo originale, dopo qualche minuto di conversazione, rallentava fino a diventare inutilizzabile.
L’idea di fondo è semplice: il PC deve vedere Emiglio come una normale webcam e un normale microfono. Così MiniCPM-o (o Discord, o qualunque altra cosa) non sa nemmeno che dall’altra parte c’è un robot.
Link componenti
- Raspberry pi zero W2
- Modulo Respeaker
- Una webcam USB qualsiasi (io uso una Trust da 640x480)
- Un PC con GPU NVIDIA con almeno 28 GB di VRAM per far girare il modello
Come funziona lo streaming
Il Pi Zero 2 W è piccolo ma ha una cosa che mi serve: l’encoder H.264 hardware. Comprimere video in software su quel processore sarebbe impossibile, con l’encoder invece i 30 fps a 640x480 li regge senza problemi e la CPU resta quasi libera. Il bitrate è a 600 kbit/s, più basso di quanto la qualità richiederebbe: l’ho abbassato apposta per lasciare respiro al Wi-Fi a 2,4 GHz, per il motivo che racconto più avanti.
Il flusso è questo: la webcam sputa fotogrammi grezzi, l’encoder li comprime in H.264 e li spedisce via UDP; in parallelo il microfono del ReSpeaker viene codificato in Opus e mandato per la stessa strada. Tutto arriva a MediaMTX, un server di streaming leggerissimo che gira sul Pi stesso e fa da centralino: chiunque vuole vedere Emiglio si collega lì.
E “chiunque” vuol dire davvero chiunque. Dal browser si apre https://ronaldo.local:8889/emiglio (sì, il Pi si chiama ronaldo) e si vede Emiglio in WebRTC con latenza bassissima. Da OBS o ffmpeg ci si aggancia via RTSP. Il PC invece se lo prende con uno script Python che lo trasforma in due dispositivi virtuali: una camera virtuale (grazie al driver di OBS) e un microfono virtuale (grazie a VB-Cable). A quel punto in qualsiasi programma scelgo “OBS Virtual Camera” e “CABLE Output” e sto usando gli occhi e le orecchie di Emiglio.
Il ritorno funziona al contrario. MediaMTX ha un secondo canale, voice, dove il PC pubblica l’audio che vuole far uscire dall’altoparlante di Emiglio. Sul Pi lo riceve un piccolo player scritto in Python, voice-player.py (lo lancia play-voice.sh): ffmpeg decodifica lo stream, una coda fa da cuscinetto e aplay riproduce sul ReSpeaker. GStreamer ormai serve solo per la cattura di webcam e microfono, e il perché lo racconto più avanti. La catena in uscita quindi è questa:
1
MiniCPM-o (audio) → bridge Python su Windows → MediaMTX (canale "voice") → voice-player → ReSpeaker
Il PC può pubblicare in due modi: dal browser, con una paginetta che cattura il microfono, oppure con il bridge che cattura direttamente l’uscita audio di Windows. Il secondo è quello che uso con MiniCPM-o: il modello parla, Windows lo sente, il bridge lo spedisce e la voce esce da Emiglio.
Per installare tutto sul Pi basta:
1
2
git clone https://github.com/AlessandroBonomo28/emiglio-stream.git
cd emiglio-stream/pi && sudo ./install.sh
Lo script installa MediaMTX come servizio, configura i flussi e genera i certificati HTTPS. Sul PC servono FFmpeg, OBS (solo per il driver della camera virtuale), VB-Cable e le dipendenze Python, tutto spiegato nel README. Poi si lancia il bridge:
1
python pc/bridge.py --return "Cuffie (Oculus" --aec
--return è il dispositivo audio di Windows su cui parla MiniCPM: il bridge lo cattura in loopback e lo manda all’altoparlante di Emiglio. --aec accende l’anti-eco, che se non lo si specifica resta spento. Ci sono anche --gate duck, che invece di azzerare il microfono lo attenua di 30 dB, e --gate-hold 2.5 per allungare la chiusura.
Una cosa che mi sono tolto dalle scatole presto è la fragilità: tutto si ricollega da solo. Se riavvio MediaMTX o cade la rete, video, audio e ritorno tornano su in pochi secondi senza che io tocchi niente. L’ho collaudato riavviando i servizi e ammazzando i processi a mano, che è l’unico modo serio di verificarlo.
MiniCPM-o 4.5 e il problema dei pochi minuti
MiniCPM-o 4.5 è un modello open source omnimodale: vede video, ascolta audio e risponde con voce, e lo fa in modalità full duplex. Nonostante i 9 miliardi di parametri (piccolo, per gli standard di oggi) sui benchmark visivi sta sopra GPT-4o. Per farlo girare servono circa 21 GB di VRAM, quindi non è roba da Pi: gira sul PC con la 5090, dentro WSL con il repo clonato direttamente (la demo ufficiale propone Docker, ma un container in mezzo avrebbe solo aggiunto latenza), e si usa da una pagina web dove si seleziona la camera, il microfono e si parte.
Con la demo ufficiale il primo test era entusiasmante: Emiglio che commenta la stanza, che risponde mentre gli parlo, che si accorge quando gli mostro un oggetto. Poi, dopo tre o quattro minuti, cominciava a rallentare. Le risposte arrivavano sempre più tardi, finché la sessione moriva.
Il motivo è la KV cache. Un modello di questo tipo, per ogni cosa che vede e sente, si tiene in memoria una rappresentazione compressa (le “chiavi” e i “valori” dell’attenzione) che gli serve per ricordare il contesto. In una chat normale il contesto cresce solo quando scrivi. In full duplex invece il modello ingoia audio e video in continuo, anche quando nessuno parla, e la cache si gonfia a ogni secondo. Quando arriva al limite del contesto il modello si impianta. La demo ufficiale lo sapeva, e infatti risolveva chiudendo la sessione a forza dopo 5 minuti con video e 10 senza. Che per un robot con cui vuoi chiacchierare è un po’ triste.
Il fork “kvpurge”
La modifica principale del fork è una finestra scorrevole sulla KV cache: quando la cache supera una soglia (4000 token di default) viene potata tagliando i token più vecchi fino a scendere a 3500. Il modello perde la memoria delle cose successe qualche minuto prima, ma mantiene il contesto recente, e soprattutto non rallenta più. Nei log ogni potatura compare come ✂ KV pruned, così si vede quanto spesso succede.
Una volta risolto questo, il timeout di 5 minuti non aveva più senso, quindi l’ho reso opzionale: se non si imposta la variabile REALTIME_MAX_DURATION_S la sessione va avanti finché non la chiudi tu. Ho anche sistemato un bug fastidioso per cui l’altoparlante scelto nella pagina veniva ignorato alla prima sessione, e con una configurazione a dispositivi virtuali come la mia questo voleva dire che la voce usciva dalle casse del PC invece che da Emiglio.
Il Wi-Fi del Pi Zero e il ritardo che cresce
C’era un secondo rallentamento, che non c’entrava niente col modello. I due sintomi si assomigliano da fuori — “dopo qualche minuto va lento” — ma sono due bug diversi, e per un po’ ho dato la colpa alla KV cache anche quando non era lei.
Il Wi-Fi del Pi Zero 2 ogni tanto si blocca, anche per più di un secondo. Su TCP un pacchetto perso ferma tutto finché non viene ritrasmesso, e quando riparte i dati arrivano tutti insieme, a raffica. Il problema non è la raffica: è cosa ci fai.
La prima versione la riproduceva per intero. Ma l’audio va in tempo reale, quindi quel secondo di arretrato non se ne andava più: restava in coda per sempre. Ogni singhiozzo aggiungeva un pezzetto di ritardo permanente, e dopo mezz’ora Emiglio rispondeva con secondi di lag. La seconda versione faceva l’opposto, buttava via l’arretrato: ritardo risolto, ma la voce usciva a pezzi. Anche il jitter buffer di GStreamer sul Pi si comportava così, scartando i pacchetti arrivati “in ritardo” — ed è il motivo per cui la riproduzione della voce è finita in un player scritto da me.
La soluzione sta nel mezzo, ed è una regola sola: non si scarta mai il parlato. Durante uno stallo Emiglio fa una pausa a metà frase e poi riprende esattamente da dove era; il ritardo accumulato lo recupera saltando solo i silenzi tra una parola e l’altra, che nel parlato sono tantissimi e che nessuno nota. La stessa logica gira nelle due direzioni: sul PC per il microfono di Emiglio, sul Pi per la sua voce.
Due trappole che mi hanno fatto perdere tempo e che vale la pena conoscere se rifate il progetto:
- Il power save del Wi-Fi sul Pi Zero 2 W è attivo di default e produce stalli periodici. Ora lo spegne
install.sh, in modo permanente. - Il “player zombie”:
gst-launchcon l’opzione-e, se la connessione cade, resta appeso ad aspettare una fine dello stream che non arriva mai, e intanto tiene occupata la scheda audio. Da lì in poi ogni nuovo player fallisce con “device busy”: lo stream arriva, il modello risponde, e lo speaker tace. È stato il bug più subdolo di tutti.
L’IA che parlava da sola e il compromesso AEC
Il problema più divertente l’ho scoperto al primo test completo. Emiglio dice una frase, l’altoparlante la riproduce, il microfono (che sta a tre centimetri dall’altoparlante) la sente, la spedisce al modello, e il modello risponde a sé stesso. Emiglio ha fatto un monologo di un minuto senza che nessuno gli parlasse.
La soluzione ideale sarebbe stata un AEC hardware (Acoustic Echo Cancellation): un chip dedicato che conosce esattamente cosa sta uscendo dall’altoparlante e lo sottrae dal microfono in tempo reale, come fanno i telefoni e le sale conferenza. Il ReSpeaker 2-Mics non ce l’ha, quindi ho provato a farlo in software sul Pi, con il modulo echo-cancel di PipeWire e il motore WebRTC.
La cosa interessante è che di calcolo ce n’era: girava intorno al 23% di un core e in laboratorio cancellava 21-27 dB di eco. È fallito per altro. Il driver Seeed mette 59 dB di guadagno sul microfono, che con l’altoparlante a pochi centimetri satura: un’eco distorta non si può sottrarre, perché non somiglia più a quello che è uscito dalla cassa. E l’AGC di WebRTC lavora dopo il cancellatore, quindi rialza proprio l’eco residuo appena abbattuto (misurato: da 21 dB di cancellazione a 11). Il risultato in uso reale era che la voce arrivava troppo bassa o disturbata e MiniCPM non rispondeva proprio. Insomma, l’ho provato e non ha retto all’uso reale.
Così ho optato per un anti-eco molto più grezzo, e l’ho messo nel bridge sul PC (pc/bridge.py, flag --aec), che è l’unico punto a vedere entrambe le direzioni: quando sta mandando la voce dell’IA a Emiglio, azzera il microfono di Emiglio verso il modello, e lo tiene chiuso per un secondo e mezzo dopo l’ultima parola, il tempo che l’eco impiega a fare il giro della rete. Sul Pi non gira niente in più, ed è esattamente il vantaggio: zero calcolo sul Pi Zero 2.
Il compromesso è evidente: questo in un certo senso “killa” il full duplex e lo fa tornare a turni, perché mentre Emiglio parla non puoi interromperlo. Con un AEC hardware si sarebbe potuto preservare, e infatti l’AEC è disattivabile: senza il flag il full duplex è completo, ma con l’altoparlante così vicino al microfono il monologo è garantito.
Detto questo, anche in versione mezza-duplex resta molto meglio della pipeline a cascata delle parti precedenti. Non solo perché c’è la vision: MiniCPM-o 4.5 è un modello end-to-end allo stato dell’arte, e la differenza si sente in ogni risposta. Ne parlo nella sezione qui sotto.
Modelli a cascata vs end-to-end
Fino alla parte 2 Emiglio funzionava a cascata: un modello di speech-to-text trascrive quello che dico, il testo passa a un LLM che scrive la risposta, e un text-to-speech la legge. Tre modelli in fila, ognuno che aspetta il precedente.
Funziona, ma ha dei limiti strutturali. Il primo è la latenza: ogni stadio aggiunge il suo tempo, e finché la trascrizione non è finita l’LLM non può nemmeno iniziare. Il secondo è che tra uno stadio e l’altro si perde informazione: la trascrizione è solo testo, quindi l’LLM non sa se ho parlato sussurrando, ridendo o arrabbiato, e il TTS a sua volta legge un testo senza sapere il contesto della conversazione. Il risultato è una voce corretta ma piatta, che suona sempre uguale qualunque cosa stia succedendo. Il terzo è che una cascata non può ascoltare mentre parla: è a turni per costruzione.
Un modello end-to-end come MiniCPM-o 4.5 è una rete sola che prende in ingresso audio e video grezzi e produce direttamente audio in uscita. Non c’è nessuna trascrizione nel mezzo: il modello sente la voce con tutte le sue sfumature e le vede riflesse nella risposta, con una generazione emotiva molto più fluida, con pause, intonazione e cambi di ritmo che una cascata non può produrre. Sotto il cofano audio e video vengono spezzettati in piccoli blocchi temporali e infilati nel contesto del modello come una sequenza unica, intervallati ai token della risposta che sta generando: è così che riesce a lavorare in streaming, un pezzetto alla volta, invece di aspettare che finisca tutto l’input. Ed è anche il motivo per cui la KV cache cresceva senza sosta: il prezzo di un modello che ascolta sempre è che deve ricordare sempre.
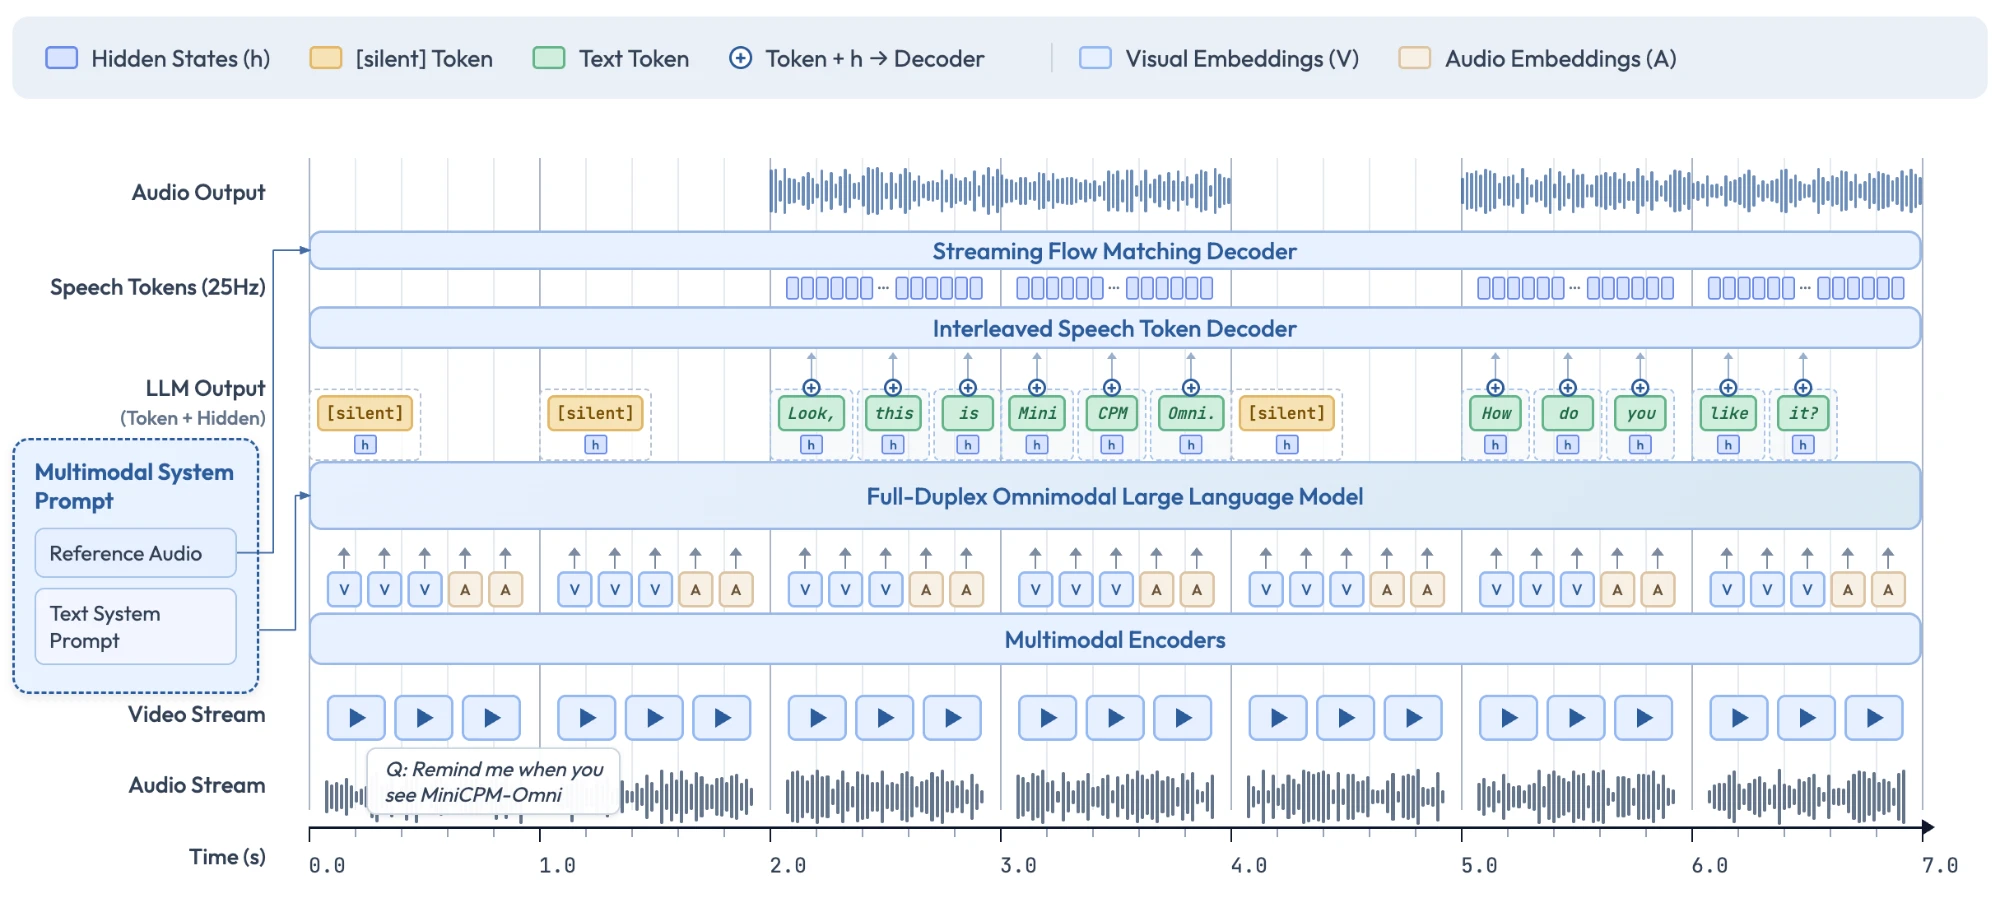 L’architettura di MiniCPM-o: video e audio entrano in continuo negli encoder, e il modello emette token
[silent] finché non decide di parlare
Lo schema qui sopra rende bene l’idea. In basso scorrono i due flussi in ingresso, spezzettati secondo per secondo; in mezzo il modello li consuma e produce token di testo che diventano subito token vocali, decodificati in audio mentre la frase è ancora in corso. E nei momenti in cui non ha niente da dire emette dei token [silent]: continua a guardare e ad ascoltare, ma sta zitto. È questo che gli permette di decidere da solo quando intervenire, invece di aspettare che qualcuno prema un pulsante.
Sui benchmark è un modello SOTA sia sulla parte visiva che su quella vocale, e lo fa con 9 miliardi di parametri, abbastanza pochi da stare su una singola GPU consumer. Per un robot che deve stare in casa, senza cloud, è esattamente la categoria giusta.
Le altre grane
Tre cose che vale la pena sapere se volete replicare il setup.
L’altoparlante del ReSpeaker è uno solo e ALSA lo apre in esclusiva: finché il player lo tiene per la voce dell’IA, la cassa bluetooth della parte 3 non può usarlo. O l’uno o l’altro, e per ora si sceglie a mano.
I certificati HTTPS sono obbligatori. Il browser non lascia accedere al microfono da una pagina in HTTP, quindi MediaMTX deve girare in HTTPS con un certificato autofirmato, e la prima volta bisogna accettare l’avviso di sicurezza. Non è elegante ma funziona.
E una curiosità che mi ha fatto perdere una mezz’ora: lo speaker del ReSpeaker 2-Mics sta sul canale destro. Se gli mandate un audio mono, quello si aggancia al canale sinistro e non sentite assolutamente niente, con tutto il resto che sembra funzionare perfettamente.
Bonus: la voce da robot
Già che il PC pubblica la voce verso Emiglio, ho aggiunto una pagina con qualche effetto fatto con Tone.js: pitch, robot, walkie-talkie, distorsione, chorus. Un modello che parla con voce umana perfetta da dentro un robot giocattolo degli anni ‘90 fa un po’ strano. Con un pizzico di distorsione e il pitch abbassato, Emiglio suona finalmente come Emiglio.
Il risultato
Emiglio ora vede quello che ha davanti, ascolta e risponde in tempo reale, senza cloud e senza limiti di tempo. Il codice è tutto nei due repo linkati sopra, con i README che spiegano ogni dettaglio che qui ho saltato.
STAY TUNED per i prossimi tutorial!
Prossimi sviluppi
- Controllo remoto e sincronizzazione con Metaquest VR
- Far guidare i cingoli direttamente all’IA
- Un full duplex vero, che richiede hardware con AEC in silicio: un ReSpeaker Lite o un XVF3800 con chip XMOS, oppure un banale vivavoce USB da conferenza, con lo speaker pilotato direttamente da quella scheda